Mengatasi Pemborosan Resource GPU Akibat Latensi Replikasi Data Terdistribusi
Di tengah eskalasi adopsi kecerdasan buatan (Artificial Intelligence) pada skala enterprise, alokasi infrastruktur GPU compute menjadi salah satu investasi paling kritis sekaligus berbiaya tinggi. Organisasi gencar melakukan provisi kapasitas GPU melalui berbagai penyedia cloud provider, data center, dan edge environment guna mengakselerasi pemrosesan training maupun inference. Kendati demikian, efisiensi operasional dari investasi komputasi ini kerap terhambat oleh tantangan mobilitas data berskala petabyte yang terisolasi (data silo) di lokasi geografis yang berbeda.
Praktik Replikasi Data Tradisional (Bencana Efisiensi Operasional)
Sistem replikasi konvensional dirancang berbasis skema disaster recovery pasif yang mewajibkan sinkronisasi full mirror dataset sebelum beban kerja (workload) dapat dieksekusi. Metodologi arsitektur lama ini memicu beberapa kendala esensial:
- High GPU Idle Time
Provisi GPU bernilai tinggi terhenti dalam kondisi idle, sementara biaya sewa infrastruktur terus berjalan sewaktu menunggu siklus penyalinan data selesai. - Storage Inefficiency & Complexity
Membutuhkan staging area atau intermediary object storage tambahan yang meningkatkan total cost of ownership (TCO) dan kompleksitas arsitektur tata kelola data. - Operational Overhead
Ketergantungan pada custom pipeline script dan transfer manual yang berisiko tinggi terhadap kepatuhan SLA operasional.
Solusi Arsitektur: WEKA NeuralMesh™ Replication bersama PT. Sapta Tunas Teknologi
Untuk mengeliminasi bottleneck data tersebut, PT. Sapta Tunas Teknologi sebagai Enterprise Solution Provider terdepan—menghadirkan integrasi solusi WEKA NeuralMesh™ Replication untuk mendesain, mengimplementasikan, dan mengoptimalkan mobilitas data pada lingkungan komputasi AI terdistribusi Anda.
WEKA NeuralMesh Replication mengadopsi pendekatan decoupled architecture dengan memisahkan sinkronisasi metadata (namespace) dari konten file fisik (data payload). Melalui fitur namespace-first visibility, kluster komputasi di lokasi tujuan dapat langsung melakukan browsing dan pengaksesan struktur direktori secara instan tanpa perlu menunggu proses replikasi fisik selesai.
Guna memastikan efisiensi konsumsi penyimpanan dan kecepatan akses, solusi ini menyediakan mekanisme hydration policy terintegrasi:
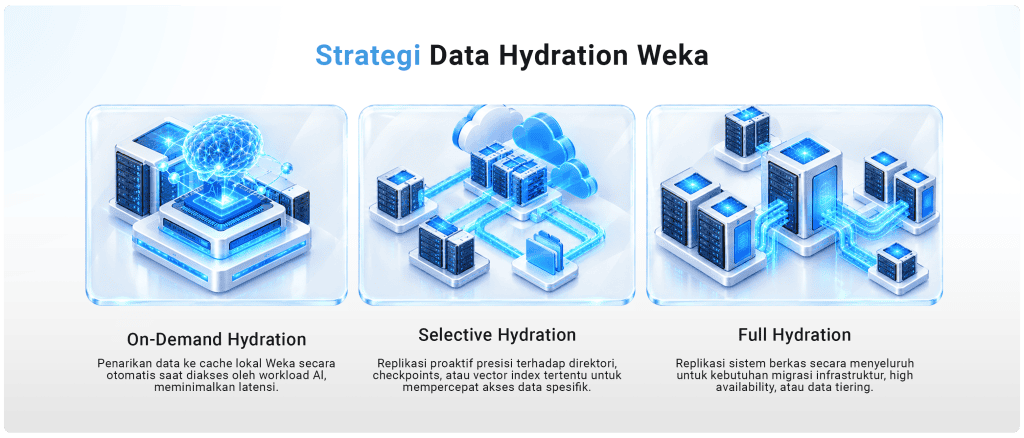
- On-Demand Hydration: Penarikan data ke cache lokal terjadi secara otomatis hanya saat diakses oleh workload AI.
- Selective Hydration: Replikasi proaktif secara presisi terhadap direktori, model checkpoints, atau vector index tertentu yang dibutuhkan.
- Full Hydration: Replikasi sistem berkas secara menyeluruh untuk kebutuhan migrasi infrastruktur atau high availability.
Transfer data dilakukan secara native langsung antar-kluster WEKA (direct cluster-to-cluster) tanpa memerlukan middleware atau object storage perantara, sehingga mampu mengoptimalkan performa throughput data secara signifikan.
Inisiasi Transformasi Infrastruktur AI Anda
Maksimalkan return on investment (ROI) pada GPU footprint Anda dan tingkatkan time-to-market inisiatif AI perusahaan dengan mengeliminasi latensi transfer data. Didukung oleh kapabilitas teknis dan konsultasi mendalam dari PT. Sapta Tunas Teknologi, organisasi Anda dapat mengadopsi teknologi WEKA secara mulus.
Hubungi tim konsultan Enterprise Solutions Specialist di PT. Sapta Tunas Teknologi hari ini untuk menjadwalkan sesi demonstrasi teknis dan asesmen infrastruktur AI enterprise Anda.
Mari berdiskusi lebih lanjut tentang IT Solutions yang Terintegrasi di platform profesional kami
Mengapa STT?
Sapta Tunas Teknologi (STT), IT Solutions yang memiliki komitmen yang tinggi dalam membantu pelanggan mencapai tujuan organisasi dan merancang IT Solutions sesuai dengan kebutuhan pelanggan yang mengikuti perkembangan tren teknologi di pasar saat ini.
- Dedicated Teams
- Certified Engineer
- Award-Winning
- Demo Solutions Center
- Trusted Partner
Referensi : https://www.weka.io/article/reimagining-replication-smarter-faster-data-movement-built-for-ai